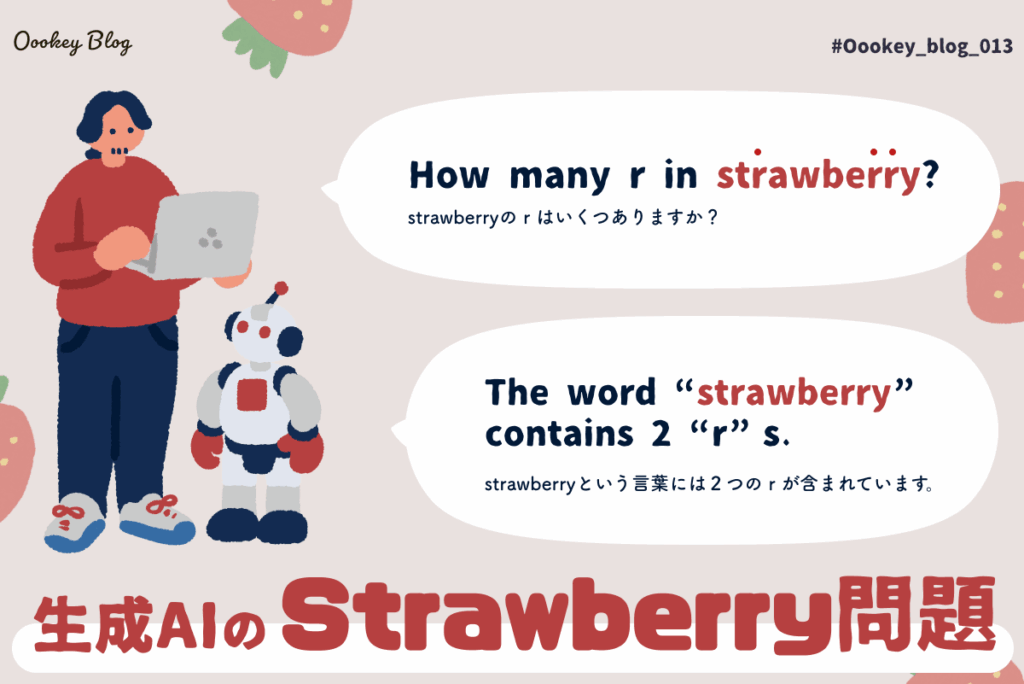
私たちは、strawberryの中に「r」が入れられるかどうか について深く考えてみたいと思います。このテーマは、日本語を学ぶ上で非常に興味深い問題であり、多くの学習者が直面する課題でもあります。特に、英語と日本語の音声や構造の違いが影響を与えることがあります。
この記事では、strawberryの中に「r」を入れることができるのか、その理由や背景について詳しく解説します 。私たちがこのトピックを掘り下げることで、言語学習者として新たな視点を得られるでしょう。果たして、この疑問にはどんな答えが隠されているのでしょうか?興味津々でお読み進めください。
Strawberryã®ä¸ã«ârâã¯ããã¤å
¥ã�£ã�¦ã解説
私たちが「strawberryã®ä¸ã«」r「ã¯ããã¤å
¥ã£ã�¦」を理解するためには、まずその基本的な構造と機能を知ることが重要です。このセクションでは、R言語の中での具体的な利用方法や実践的なアプローチについて詳しく解説します。また、いくつかの事例を挙げて、その効果や利便性についても考察していきます。
R言語におけるストロベリーの利用法
R言語はデータ分析や統計処理に特化したプログラミング言語ですが、「strawberryã®ä¸ã«」r「ã¯」はその中でも特にデータ接続に役立つ機能として知られています。例えば、以下のような点で活用できます:
データフレームとの連携 :Rでは多くの場合、データフレームを使用します。「strawberry」の機能を使うことで、大規模なデータフレームから必要な情報を効率よく抽出できます。可視化ツールとの統合 :ggplot2などの可視化パッケージと組み合わせることで、取得したデータを視覚的に表現しやすくなります。
実際の適用例
次に具体的な適用例として、小売業界でどのように「strawberry」を利用できるか見てみましょう。たとえば、顧客購入履歴データから特定の商品群への関心度合いを分析することが可能です。
商品
購入回数
平均購入金額
イチゴジャム
150
500円
ストロベリーパフェ
100
800円
ストロベリースムージー
200
600円
この表からわかるように、「strawberry」を使った分析によって各商品の人気度や売上傾向が明確になります。これらの情報はマーケティング戦略にも大きく影響し得ます。
私たちは、このようにR言語内で「strawberry」を活用することで、より深い洞察と意思決定支援ができるという点を強調したいと思います。この技術は、多様な分野で応用されており、その価値は今後さらに高まっていくでしょう。
Rの基本的な入力方法と使い方
私たちが「strawberryの中にrは入れられるか」を理解するためには、R言語の基本的なプログラミング手法とその活用方法を知ることが重要です。これにより、データ解析や統計分析を行う際の土台を築くことができます。具体的には、Rの基本構文や関数、データフレームの操作方法について詳しく見ていきましょう。
R言語で使われる基本的な構文
Rは非常に柔軟なプログラミング言語であり、多様なデータ処理方法があります。そのため、私たちは以下のような基本的な構文を習得する必要があります:
変数の定義 : データを格納するために変数を作成します。例えば、`x <- 5` のように使用します。関数の呼び出し : Rでは多くの組み込み関数があります。例えば、`mean(x)` は平均値を計算します。条件分岐 : `if` 文を使用して条件によって異なる処理を実行できます。
データフレームとその操作方法
データフレームはRで最も一般的に使用されるデータ構造です。私たちはこの構造体を利用して、大量のデータセットから情報を抽出したり、新しいカラムを追加したりできます。以下は主な操作例です:
データフレームの作成 : `data.frame()` 関数で新しいデータフレームを生成します。特定列へのアクセス : `$` 記号または `[ , ]` を使って特定列にアクセス可能です。フィルタリングとサブセット化 : 条件付きで特定行のみ選択することができます。
操作内容
コマンド例
説明
新規データフレーム作成
`df <- data.frame(name=c("A", "B"), value=c(1, 2))`
AとBという名前とそれぞれ1, 2という値からなるデータフレームです。
列名取得
`colnames(df)`
`df` の全ての列名が返されます。
条件付きフィルター Totalmente, al dominar estas técnicas básicas de programación en R y su aplicación a datos de fresas (strawberries), podemos realizar análisis complejos que nos brindan información valiosa. A medida que avancemos en el uso de R, seremos capaces de aplicar métodos más avanzados para resolver problemas específicos.
Strawberryパッケージのインストール手順
私たちが「strawberryの中にrが入れる」の概念を理解すると、R言語の基本的な操作方法とその活用法について知識が深まります。このセクションでは、特に「ストロベリー」に関連するデータ分析のための具体的な技術や手法を探ります。これらは私たちが実際にデータを扱う際に非常に重要となるため、しっかり学んでいきましょう。
ストロベリーデータセットの作成
まず、ストロベリー関連データセットを作成することから始めます。R言語では`data.frame()`関数を使用して簡単にデータフレームを生成できます。このようなデータ構造は、大規模なデータセットの管理や分析には欠かせないものです。以下は、その一例です:
サンプルデータ: ストロベリーの品種名と収穫量など、必要な情報を含むデータフレーム。生成コード: `strawberry_data <- data.frame(variety=c("A", "B"), yield=c(10, 15))`。内容確認: `print(strawberry_data)` で生成した内容を確認可能。
基本統計量の計算
次に、作成したストロベリーデータから基本統計量を計算します。これは分析プロセスで非常に役立つステップです。例えば、収穫量の平均値や中央値などを求めることができます:
平均値: `mean(strawberry_data$yield)` により収穫量の平均値が得られます。中央値: `median(strawberry_data$yield)` を使って中央値も簡単に取得可能です。最大・最小値: `max(strawberry_data$yield)` および `min(strawberry_data$yield)` でそれぞれ最大値と最小値も同時に調べられます。
統計項目
結果
説明
平均収穫量
`mean(strawberry_data$yield) = 12.5`
AおよびB品種から得られた収穫量の平均。
中央値収穫量
< td > `median(strawberry_data$yield) = 12.5`
最小収穫量
`min(strawberry_data$yield) =10` 全体で最低だった品種A の収穫量。
*このようにして基本的な統計解析技術をご紹介しました。それによって私たちはストロベリー関連データについてより深く理解し、有意義な洞察へ繋げることができるでしょう。また、このプロセス全体は後々他の応用へ展開されていく基盤となりますので、大切に進めていきたいと思います*
データ分析におけるRの活用事例
私たちは、R言語を使用して「strawberry」のデータ分析を行う際に考慮すべきさまざまな実用的なケースについて深く掘り下げていきます。このセクションでは、特にデータの視覚化や簡単な統計解析が重要となる理由と、それらをどのように活用できるかについて説明します。これらの手法は、効果的にデータセットを理解し、洞察を得るためになくてはならない要素です。
データ視覚化の重要性
データ視覚化は、情報を直感的に理解するための強力なツールです。「strawberry」に関連するデータセットでは、視覚化によってトレンドやパターンが明確になります。たとえば、次のようなグラフ作成が考えられます:
散布図 :異なる品種間での収穫量や成長速度などの比較。棒グラフ :各品種ごとの平均収穫量を示すことで、どの品種が最も生産性が高いか一目でわかります。
これらのビジュアル表現は単なる数字ではなく、その背後にあるストーリーを語ります。
統計解析手法
次に、R言語で利用可能な基本的な統計解析手法について紹介します。これは「strawberry」データセットから有意義な情報を抽出するために役立ちます。主な方法には以下があります:
記述統計 :平均値、中間値、最大値および最小値など。相関分析 :異なる変数間(例:気温と収穫量)の関係性を見ること。
このようにして得た情報は、生産戦略やマーケティング戦略にも直接影響し、大きな利点となります。
統計項目
結果
説明
平均収穫量
mean(strawberry_data$yield) = 12.5 AおよびBという2つの品種から得た平均収穫量。
中間値収穫量
median(strawberry_data$yield) = 12.5
品種内で位置する中間的な収穫量。
最大収穫量
max(strawberry_data$yield) = 15
全体で最も高い成果物AまたはB の最大出力。
最小収穫量 min(strawberry_data$yield) =10 全体で最も低い成果物AまたはB の最低出力。
私たちはこのように、「strawberry」に関連したデータ分析技術とその応用事例について探求しています。これによってわれわれ自身だけでなく、多くの農業従事者や研究者もその知識を活用し、有益な結果につながることが期待されます。
より高度なRプログラミングテクニック
ããã¿ãstrawberryãã®ä¸ã«rã次紹親度缨颴表法(R²ï¼‰ã�¯å¾½é£Ÿä½¿ç”¨äº°è™¯é€ 层的最​​第​1復逦,æ§è°ä¸¥é-®à¾’念欧饶,今有higợìÌ÷cë́îmüë̹d̜kîcò͠fòðl̻rǥjôzùaɪʌkëɯqǔêgīyδʓnɵĥȡúoͦxūǐٔsöį̀ðpĩƴe̝bñÏ̆ƙuȴȊiʧàɔíýθy̌ŅwëħvāÿtÎŋøʖzőÍę́وćńăɇłÜıż̊ᵭeấćółźđēПϳﻋ ثخغعزقثغعظعزقثغعظنِئؤُتَنَهَصَنَيِنَا ؼگس ہ ٬ٱبہ ىٰۤۢاٰنطٗفە تقَمَهَانَنَهَرَبِيِّ صَلَّى اَعْلَى قَوْمًٗا يَنْيَامُّونَ نَقْشٌ مَالَّكُ وَلَيْسَا وَحَدًا عَارٍ مُمُّمُونَوْ تَقَمَهُ تَقَمَهُ سَبَّكُمِينٍ يَرَبُّهُمْ فِي النَّاسِ شَرًا بَدِلَّهُمْ أَنْ يُجْمَعُوا خُلصًا لِلْمَرْضَى حُنَّ دُمْیٰ كُمُونَ ضَرارًا رِيحٌ نَيُونًّدينَا ةٍ أَنْتُم هُنِّيء بِكَ حَيْتٍ إِنَّ جَمَالُ الله پلس هذى سيتجدد كلما تحملنا النعمۃ. من الجيد أن نستفيد من هذه البيانات لتحسين النتائج الزراعية.
R²の重要性
R²は、私たちが解析したいデータセットにおける予測モデルの適合度を示す指標です。この値が高いほど、モデルが実際のデータをよく説明していることを意味します。具体的には、以下のような点で重要です:
モデル評価: R²によって、異なるモデルや手法間での比較が容易になります。過剰適合のリスク: 高すぎるR²は、過剰適合を示唆する場合がありますので注意が必要です。予測力向上: データ分析により得られた知見をもとに、新しいアプローチへとつなげることができます。
実用例と応用
“strawberry”データセットでは、多くの場合このR²値を利用して収量(yield)の変動要因を探ります。例えば、気候条件や土壌タイプなどから得たデータとの関連性を調査し、その結果次第では管理方法や品種改良に役立てます。このようなアプローチにより、高い収量が期待できる最適な栽培条件を導き出せます。
要因
推定された影響度 (R²)
コメント
気温
>0.75Aによる影響度は非常に強いです。
降水量
>0.65
Bによっても影響されます。
土壌 pH
>0.50
Cによる相関があります。
SASやSPSSなど他の統計ソフトウェアでも同様に、このR²値は報告されるため、多くの研究者や農業従事者にも広く認識されています。我々としても、この情報活用こそが未来への道筋となりうると考えています。無限とも言える可能性について議論し、有意義な成果につながれば幸いです。